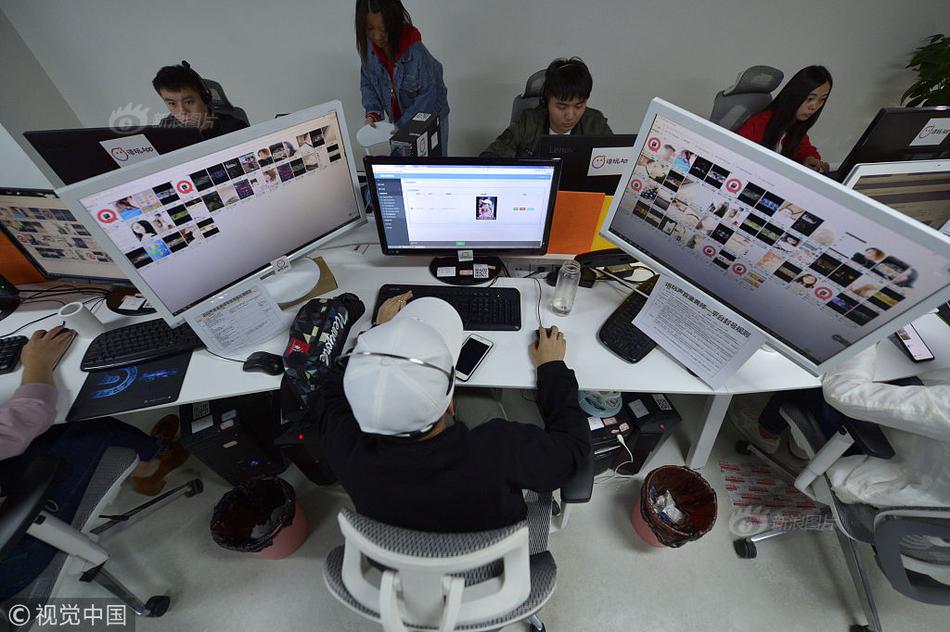
短视频不良内容识别可以帮助平台、学校或家庭发现色情暗示、暴力伤害、欺凌辱骂、诈骗诱导和危险模仿等风险,但识别结果并不等于对视频作出最终定性。画面、字幕、语音、人物关系和发布语境可能互相矛盾;如果只凭单个词语或一帧画面判断,就可能误删正常表达,也可能漏过经过伪装的有害内容。较稳妥的做法,是把自动识别用于初筛,把明确规则、必要的人工复核和隐私保护纳入同一流程。
识别风险往往出在哪里
语境被切断,容易误判。同一段打斗画面可能是新闻报道、影视表演、反暴力科普,也可能是在鼓励现实伤害;出现敏感词,也可能是在引用、批评或求助。模型若只读字幕或抽取单帧,可能把讨论风险误作宣扬风险。判断时应结合前后镜头、配音语气、标题说明和作品用途,避免用孤立线索直接处罚。
隐晦表达和多模态拼接,容易漏判。有害意图可能藏在谐音、拆字、贴纸、背景音或快速闪过的画面中,也可能由标题、评论引导和视频主体共同构成。单独检查画面、语音或文字,未必能看出整体含义。识别系统需要将不同线索相互印证;对短暂、低清或遮挡严重的片段,应降低自动处置的确定性,而不是把“没有识别出来”当作“没有风险”。
群体差异会带来偏差。方言、口音、少数群体用语、戏仿和流行梗可能被误读为辱骂或违规表达;相反,熟悉某种表达习惯的人也可能忽视其中的针对性伤害。若训练和复核样本过于单一,误判便可能集中落在特定地域、年龄或表达方式上。应持续检查不同群体的误报、漏报情况,并允许当事人说明语境。
风险等级混在一起,会导致处置失当。令人不适的表达、针对个人的持续骚扰、诱骗未成年人以及鼓励现实伤害,严重程度并不相同。若系统只给出一个“正常/不良”标签,审核者难以决定是提示、限流、删除还是升级处理。应将问题类型与紧急程度分开记录,并让处置强度与具体行为及潜在伤害相匹配。
样本与审核数据也可能泄露隐私。识别视频时,画面可能包含未成年人、家庭住址、学校标识、车牌或求助者身份。将原片长期留存、随意转发给审核人员,或把无关个人信息写进备注,都会扩大暴露范围。采集与复核应限定在必要范围,减少不相关信息,设置访问权限和保存期限,并避免把敏感片段用于无关训练或展示。
判断条件:看组合证据,不看单一标签
识别前应先明确规则针对什么行为、适用于什么场景,以及不同后果如何区分。可以综合以下线索,但每一项都应放回上下文判断:
- 画面与动作:检查是否出现真实伤害、明显性化呈现、危险操作或针对某人的羞辱行为,同时区分新闻、表演、教育和虚构情节。
- 语音与文字:关注是否有明确威胁、诱骗、鼓动模仿、诈骗指令或针对特定对象的持续攻击;引用、反驳和求助不应仅因关键词相同而自动归为违规。
- 人物与关系:留意是否涉及未成年人、被胁迫者或可识别的受害人,并判断发布者是在保护、揭露问题,还是借此羞辱、牟利或引导接触。
- 发布与传播方式:结合标题、配文、重复发布、评论引导和外部联络暗示,判断是否存在持续诱导、扩散伤害或规避审核的迹象。
只有多项线索相互支持、且能对应到清晰规则时,才适合采取较强处置。证据不足或语境冲突时,应进入复核,而不是让模型的置信分数替代事实判断。
防护方法:让识别、复核和申诉形成闭环
先做分级,不把模型当裁判。自动识别可用于排序和提示风险;涉及严重伤害、未成年人或可能造成现实危险的情况,应由受过规则培训的人员复核。低置信度、语境复杂和用户提出异议的案例,要保留重新判断的通道。处置记录应说明触发依据,避免只写“系统判定”。
按风险选择措施。轻微且不确定的情况可先提示或限制推荐;证据充分的违规内容再按规则处理;存在紧迫人身危险的线索则应及时升级到相应的安全处置流程。不同措施要能解释,也要避免因一次误判永久限制账号或公开暴露当事人。
控制数据范围并保护复核者。仅让有职责的人查看必要片段,对身份信息做遮挡或脱敏;限制复制、下载和二次传播,定期清理已无处理用途的材料。审核人员接触高冲击画面时,应有明确的工作边界与轮换安排。
保留反馈并检查偏差。用户应能提交补充语境、说明引用或教育用途,并获得可理解的处理理由。定期抽查误报和漏报,比较不同语言、地区和内容类型的表现;发现某类表达被集中误伤时,应调整规则和复核样本。识别能力也会被新梗、剪辑和遮挡方式影响,因此需要持续评估,而非把一次测试结果当成永久保证。
短视频不良内容识别的安全边界,在于辅助发现风险,而不是自动给创作者贴标签。规则清楚、证据完整、处置有等级、数据少留存且允许申诉,才能在减少有害传播的同时,降低误删正常内容和伤害个人权益的风险。
决胜“十四五” 打好收官战 | 做好“减震器”“稳定器”!“十四五”期间保险业保障能力持续提高
2026-10-23 07:29:0652318
教别人用AI,我赚翻了
2026-10-18 14:26:061168216
SpaceX 完成首次投资级债券发行,募资至少 250 亿美元
2026-10-23 19:34:066946218
亚马逊正筹备新一轮企业裁员,预计将影响高达15%的人力资源团队
2026-10-26 04:24:068214568
小杨这两个上篮纯巨星球
2026-10-15 20:16:0678707956